MinerU
製品の状態: 状態未登録
この項目にはライフサイクルの確認記録がありません。掲載は現在の利用可否を保証しません。利用前に提供元へ確認してください。
状態の確認日は未登録
AI 向けの文書解析。PDF、Office ファイル、画像をレイアウト・数式・表を保った構造化 Markdown に変換します。 この項目にはライフサイクルの確認記録がありません。掲載は現在の利用可否を保証しません。利用前に提供元へ確認してください。
プロダクトプレビュー
詳細レビュー
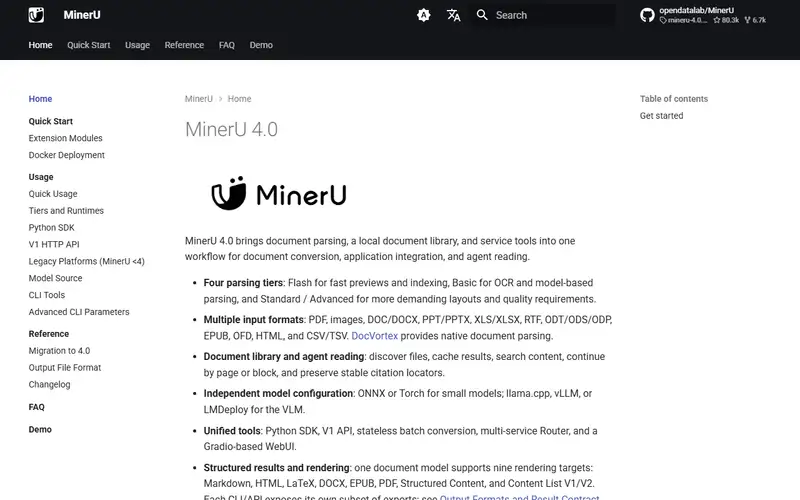
MinerU は人間向けに書かれた文書を、モデルが読める形に変換します。入力は PDF、Office ファイル、画像。出力はレイアウト、読み順、数式、表を保った構造化 Markdown です。ライブラリ、CLI、サービスとして動作し、バックエンドを切り替えられます。ONNX や Torch 上の小型モデル、あるいは llama.cpp、vLLM、LMDeploy で供する VLM です。ページとブロックの位置情報も保持するため、下流のエージェントが記述の出所を引用できます。
ここは検索品質が決まる、地味な工程です。理由は PDF そのものにあります。PDF が記述しているのは「インクがどこに置かれるか」であり「文字が何を意味するか」ではありません。二段組の論文、ページをまたぐ表の行、グリフの寄せ集めになった数式、テキスト層のないスキャンページ。下流の分割戦略はすべてこの段階の結論の上に成り立ち、行の途中で切れた表は後からどう調整しても取り返せません。だから解析は、通常は埋め込みモデルに費やされる注意を受ける価値があります。留保は、品質が領域に強く依存することです。学術論文で調整した処理系は、請求書やスキャンした帳票では違う挙動をします。試すべきは自社の文書種別です。
出典
このレビューの事実に関する記述は、以下のページから読み取りました。日付は編集者が最後にその出典を開いた日であり、製品が変更された日ではありません。
- ベンダー公式ドキュメント 確認日 2026-09-19
- ベンダー公式ドキュメント 確認日 2026-09-19
長所 / 短所
長所
- 素朴な抽出が意味を静かに壊す文書種別を扱える。二段組、表、数式、スキャン
- 位置情報を保つため、下流の回答が根拠の出所を引用できる
- オープンソースでローカル実行でき、バックエンドを選べる
短所
- 解析品質は領域依存で、本項目ではどの文書集合でも検証していません
- VLM のバックエンドは GPU 要件を伴い、小型モデル構成なら不要です
- リポジトリのライセンスは非標準と報告されており、商用利用の前に条件を読むべきです
こんな人におすすめ
論文や報告書からの RAG コーパス構築
PDF の表を構造化データとして抽出
スキャン文書を検索可能にする
エージェントに引用可能な文書文脈を与える
総評
検索が起きる前に検索品質を決める文書解析。ばらつきは自社の PDF にあるので、そこで試してください。
主な機能
タグ
よくある質問
MinerU は現在利用できますか?
この項目にはライフサイクルの確認記録がありません。掲載は現在の利用可否を保証しません。利用前に提供元へ確認してください。
MinerU とは?
MinerU は OpenDataLab が開発したエージェントと開発ツールツールです。AI 向けの文書解析。PDF、Office ファイル、画像をレイアウト・数式・表を保った構造化 Markdown に変換します。
MinerU は無料ですか?
はい——MinerU は無料で利用できます。
MinerU はオープンソースですか?
はい——MinerU はオープンソースです。ソースコードは https://github.com/opendatalab/MinerU で公開されています。
MinerU のおすすめの代替ツールは?
注目のエージェントと開発ツール代替ツールには Firecrawl、Browser Use、Daytona などがあります。カテゴリーページで全 33 件のツールをご覧ください。
このページは役に立ちましたか?