MinerU
产品状态: 尚未登记状态
本条目尚未登记生命周期复核。被目录收录不代表当前可用,选用前请向厂商确认。
尚未记录状态查看日期
面向 AI 的文档解析:把 PDF、Office 文件与图片转成结构化 Markdown,处理版面、公式与表格。 本条目尚未登记生命周期复核。被目录收录不代表当前可用,选用前请向厂商确认。
产品预览
深度介绍
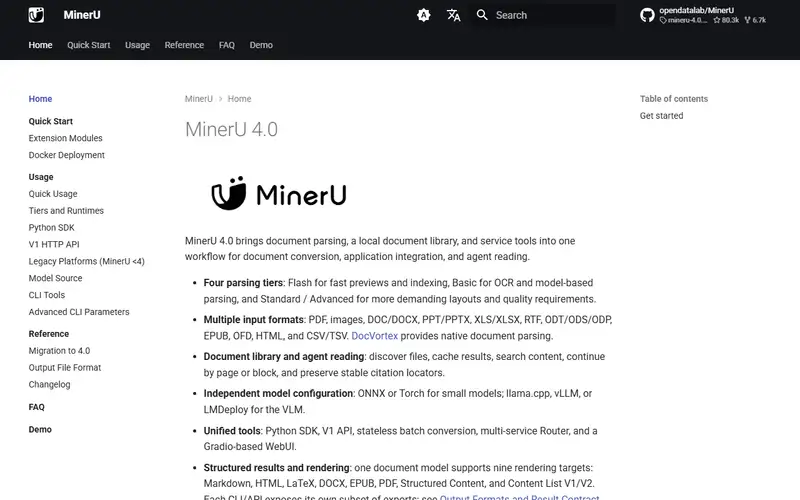
MinerU 把人写给人的文档转成模型能读的东西:输入 PDF、Office 文件与图片,输出保留版面、阅读顺序、公式与表格的结构化 Markdown。它可作为库、CLI 或服务运行,并可指向不同后端——ONNX 或 Torch 上的小模型,或经 llama.cpp、vLLM、LMDeploy 提供的 VLM。它还会保留页码与区块定位,让下游 agent 能引用某句话的出处。
这正是决定检索质量的那个不好看的环节,而原因就在 PDF 本身。**PDF 描述的是「墨迹落在哪里」,不是「文字是什么意思」**:双栏论文、跨页的表格行、变成字形堆的公式、根本没有文字层的扫描页。下游任何切块策略都建立在这一步的结论上,而一行被从中间切开的表格,后面再怎么调都救不回来——所以解析值得拿到通常花在嵌入模型上的那份注意力。前提是质量与领域高度相关:在学术论文上调好的管线,遇到发票或扫描表单会表现不同,所以要测的是你自己的文档类型。
资料来源
本篇的事实性陈述来自以下页面。日期是编辑最后一次打开该来源的日期,不是产品发生变更的日期。
优点 / 缺点
优点
- 能处理「朴素抽取会悄悄毁掉含义」的那些文档类型:双栏、表格、公式、扫描件
- 保留定位信息,下游答案能引用结论的出处
- 开源、可本地运行,后端可选
缺点
- 解析质量与领域强相关,本条目未在任何文档集上测试
- VLM 后端带来 GPU 需求,小模型方案则不需要
- 仓库许可被标注为非标准,商用前应读条款
适合谁用
从论文或报告构建 RAG 语料
把 PDF 中的表格抽成结构化数据
让扫描文档可检索
给 agent 可引用的文档上下文
编辑结论
在检索发生之前就决定检索质量的文档解析——用你自己的 PDF 去测,差异正是出在那里。
核心功能
标签
常见问题
MinerU 目前还能使用吗?
本条目尚未登记生命周期复核。被目录收录不代表当前可用,选用前请向厂商确认。
MinerU 是什么?
MinerU 是由 OpenDataLab 开发的智能体与开发工具工具。面向 AI 的文档解析:把 PDF、Office 文件与图片转成结构化 Markdown,处理版面、公式与表格。
MinerU 是免费的吗?
是的——MinerU 可以免费使用。
MinerU 是开源的吗?
是的——MinerU 是开源软件,源代码可在 https://github.com/opendatalab/MinerU 公开获取。
MinerU 有哪些最佳替代品?
值得关注的智能体与开发工具替代品包括 Firecrawl、Browser Use、Daytona。你可以在我们的智能体与开发工具分类中浏览全部 33 个工具。
这个页面有帮助吗?