Triton Inference Server
产品状态: 尚未登记状态
本条目尚未登记生命周期复核。被目录收录不代表当前可用,选用前请向厂商确认。
尚未记录状态查看日期
NVIDIA 的推理主力:批处理与多模型服务榨干每块 GPU。 本条目尚未登记生命周期复核。被目录收录不代表当前可用,选用前请向厂商确认。
产品预览
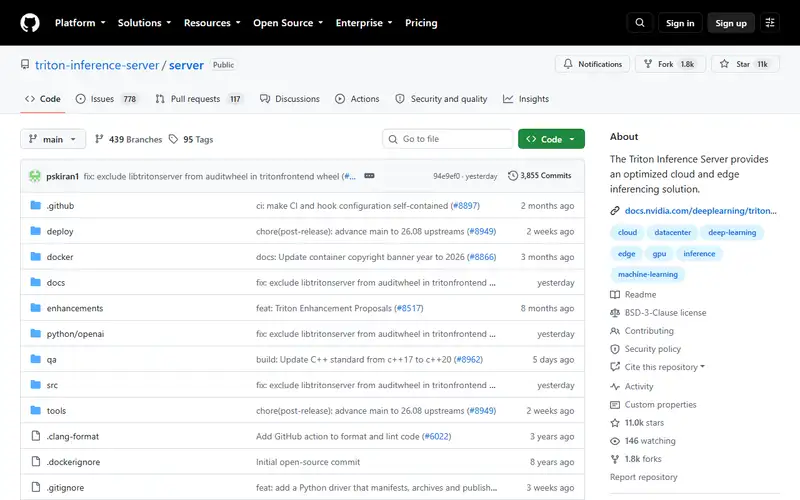
深度介绍
Triton 是 NVIDIA 的推理服务器:一个进程同时服务来自多种不同运行时后端的模型,用 HTTP 与 gRPC 以及 OpenAI、KServe 客户端已经会讲的接口把它们暴露出去,并输出指标供人观察部署。文档的快速上手清单覆盖 TensorRT-LLM、vLLM、Python 配 Hugging Face 模型、PyTorch、ONNX 与 OpenVINO;功能清单里包含大语言模型需要的那几手——受约束解码、函数调用与推测解码。它是企业把整片模型资产指向的那种无聊而可靠的层。
它适合把许多模型(尤其是视觉、语音与向量化工作负载)归并到共享显卡上、并且需要用数字证明利用率与健康度的团队。把「从笔记本到跑起来的端点」这条路径最短当作优先的人则不太适合:向这个服务器描述一个模型,意味着按要求的形状摆好模型仓库、并且写配置,第一个请求才能成功——这是实实在在的成本,尽管每种后端都有一份快速部署指南。纯语言模型服务同样不太适合:那是专用引擎跑得最快的地方。
未核实:本次没有安装服务器,也没有加载模型,因此批处理行为、多后端的主张与指标输出都没有观察。后端与功能清单来自厂商的文档页。仓库接口显示约 11,069 星、1,853 个分支、BSD 三条款许可,最后一次推送在 2026 年 10 月 10 日,因此撰写当日项目是活跃的;其发布说明与兼容性矩阵没有读,因此哪个版本配哪个库版本没有核查。另需注意:这个名称也被一个与此无关的编译器项目使用,而那个项目本次没有考察。
本条目尚未登记内容来源。目录收录和既有评分不代表相关主张已获独立验证。
优点 / 缺点
优点
- 批处理能到的都榨出来
- 一个服务器多框架
- 原生 Prometheus 指标
- NVIDIA 芯片上 NVIDIA 实测
缺点
- 首个请求前先翻配置山
- LLM 服务让位给 vLLM/SGLang
- 要求模型仓库纪律
适合谁用
高吞吐视觉语音服务
多模型 GPU 归并
带指标的企业推理
批量打分农场
编辑结论
NVIDIA 的多后端模型服务器——视觉、语音、语言混合模型资产的归并层,代价是第一个请求通过之前先要把配置做完。
核心功能
标签
常见问题
Triton Inference Server 目前还能使用吗?
本条目尚未登记生命周期复核。被目录收录不代表当前可用,选用前请向厂商确认。
Triton Inference Server 是什么?
Triton Inference Server 是由 NVIDIA 开发的AI 平台工具。它于 2018 年推出,开发方总部位于美国圣克拉拉。NVIDIA 的推理主力:批处理与多模型服务榨干每块 GPU。
Triton Inference Server 是免费的吗?
是的——Triton Inference Server 可以免费使用。
Triton Inference Server 是开源的吗?
是的——Triton Inference Server 是开源软件,源代码可在 https://github.com/triton-inference-server/server 公开获取。
Triton Inference Server 有哪些最佳替代品?
值得关注的AI 平台替代品包括 Hugging Face、Replicate、Ollama。你可以在我们的AI 平台分类中浏览全部 138 个工具。
这个页面有帮助吗?